

选择你要做的事
评测与自迭代处于 Beta 阶段。对比时固定评测集、评分标准和运行资源,避免把测试条件变化当成 Agent 能力变化。
完成第一次评测
准备一个可运行的 Agent 版本与环境。任务依赖外部服务、文件或记忆时,同时准备凭据库和对应资源。1
创建评测集
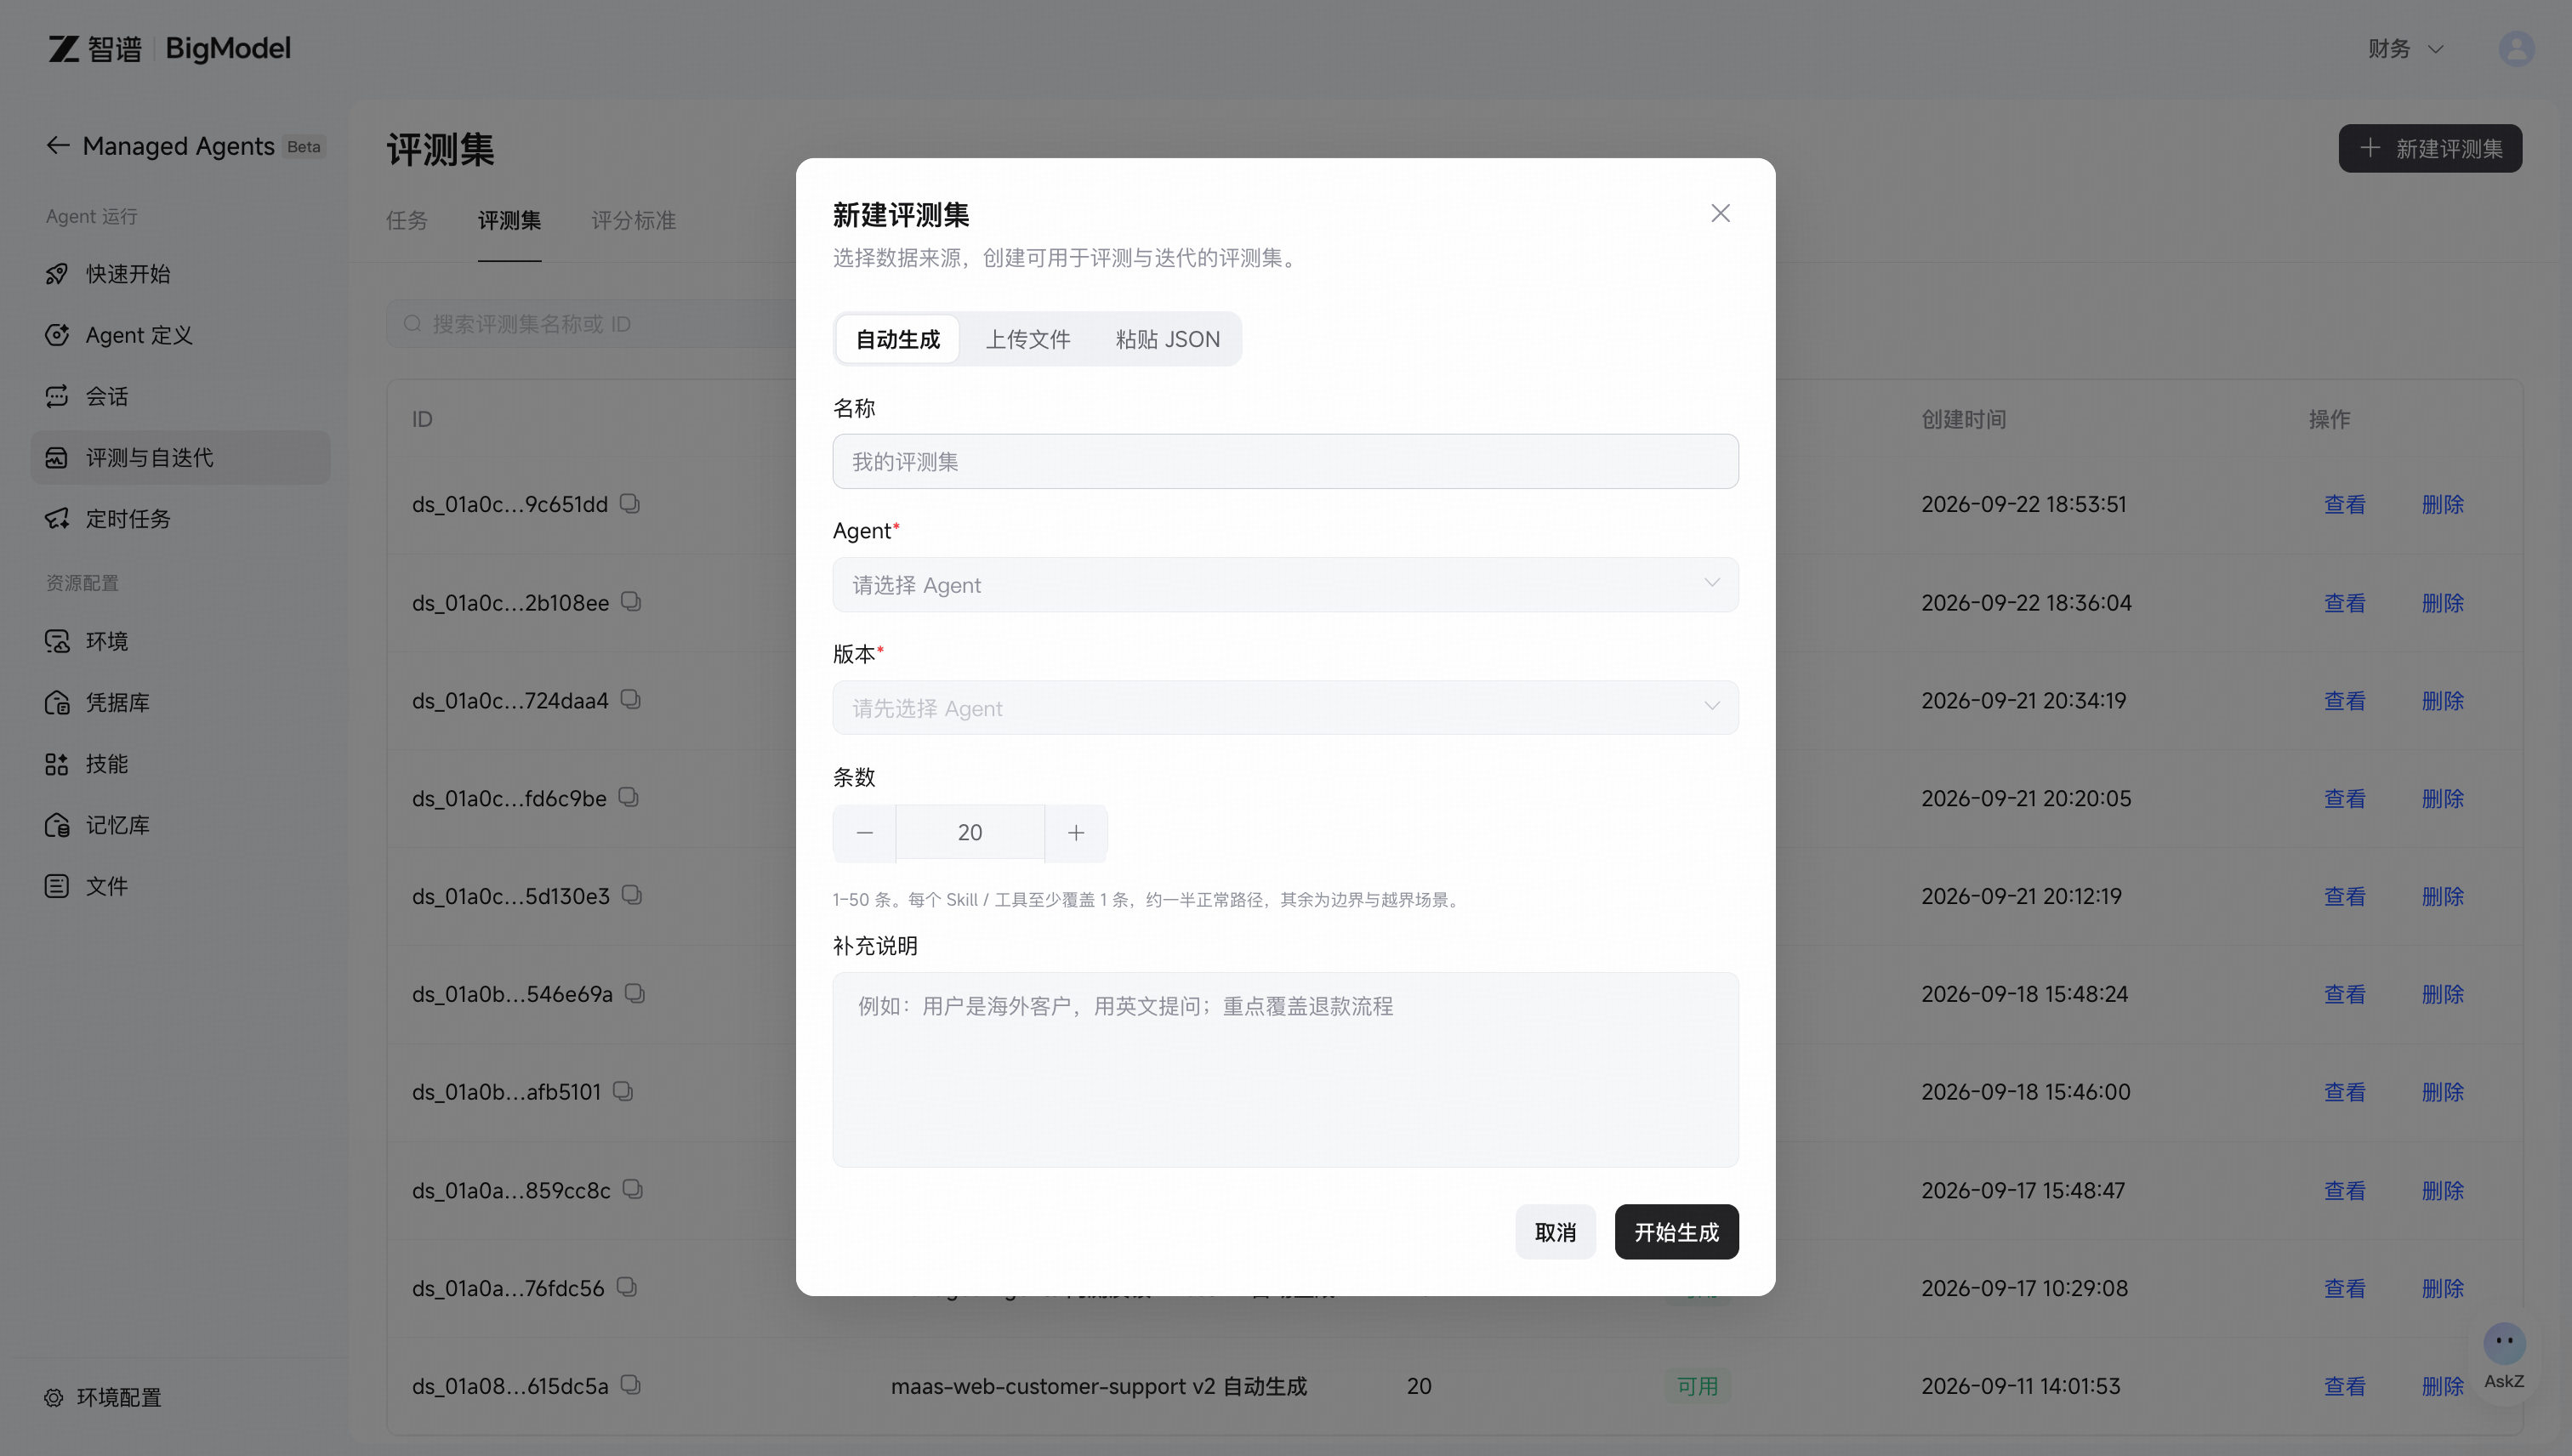
进入 评测集 → 新建评测集。选择上传文件、粘贴 JSON 或 AI 生成。第一次建议先准备 10–30 条人工核对过的数据,覆盖正常任务、边界输入和已知失败。
2
创建评分标准
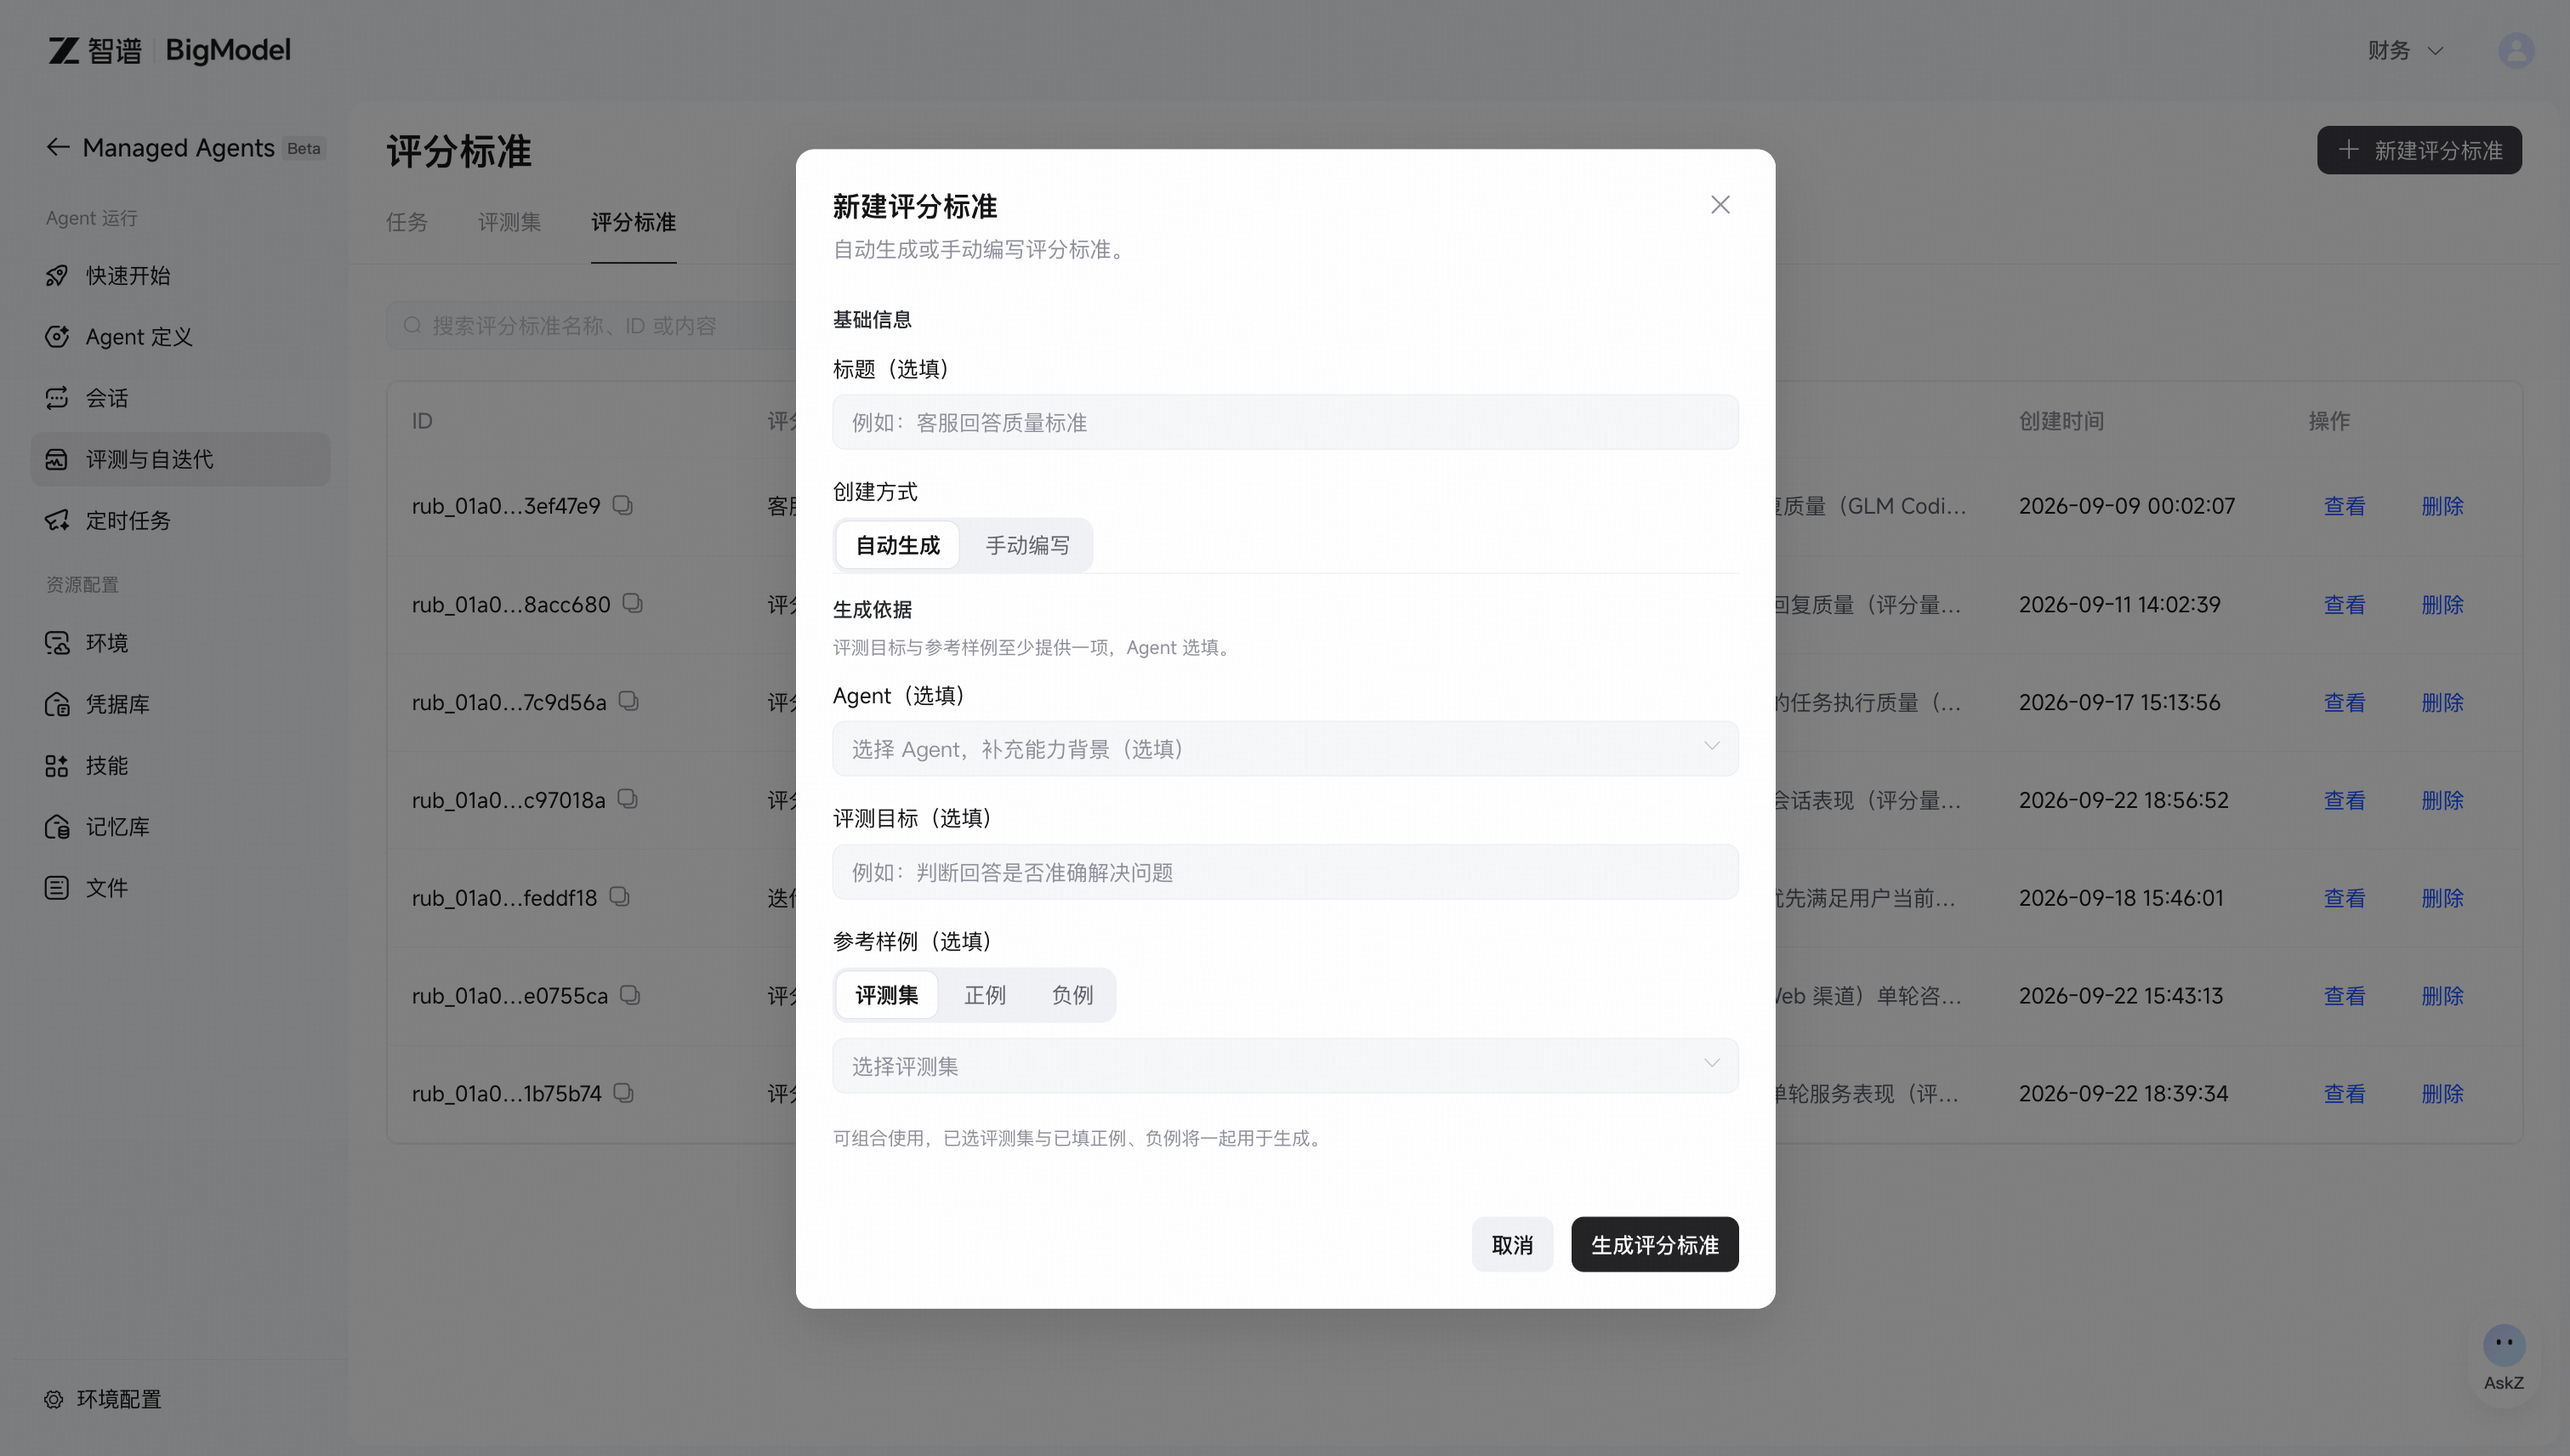
进入 评分标准 → 新建评分标准,手动编写,或提供目标与样例自动生成。写清判断条件、分值和不合格情形;AI 生成后也应人工检查。
3
开始评测
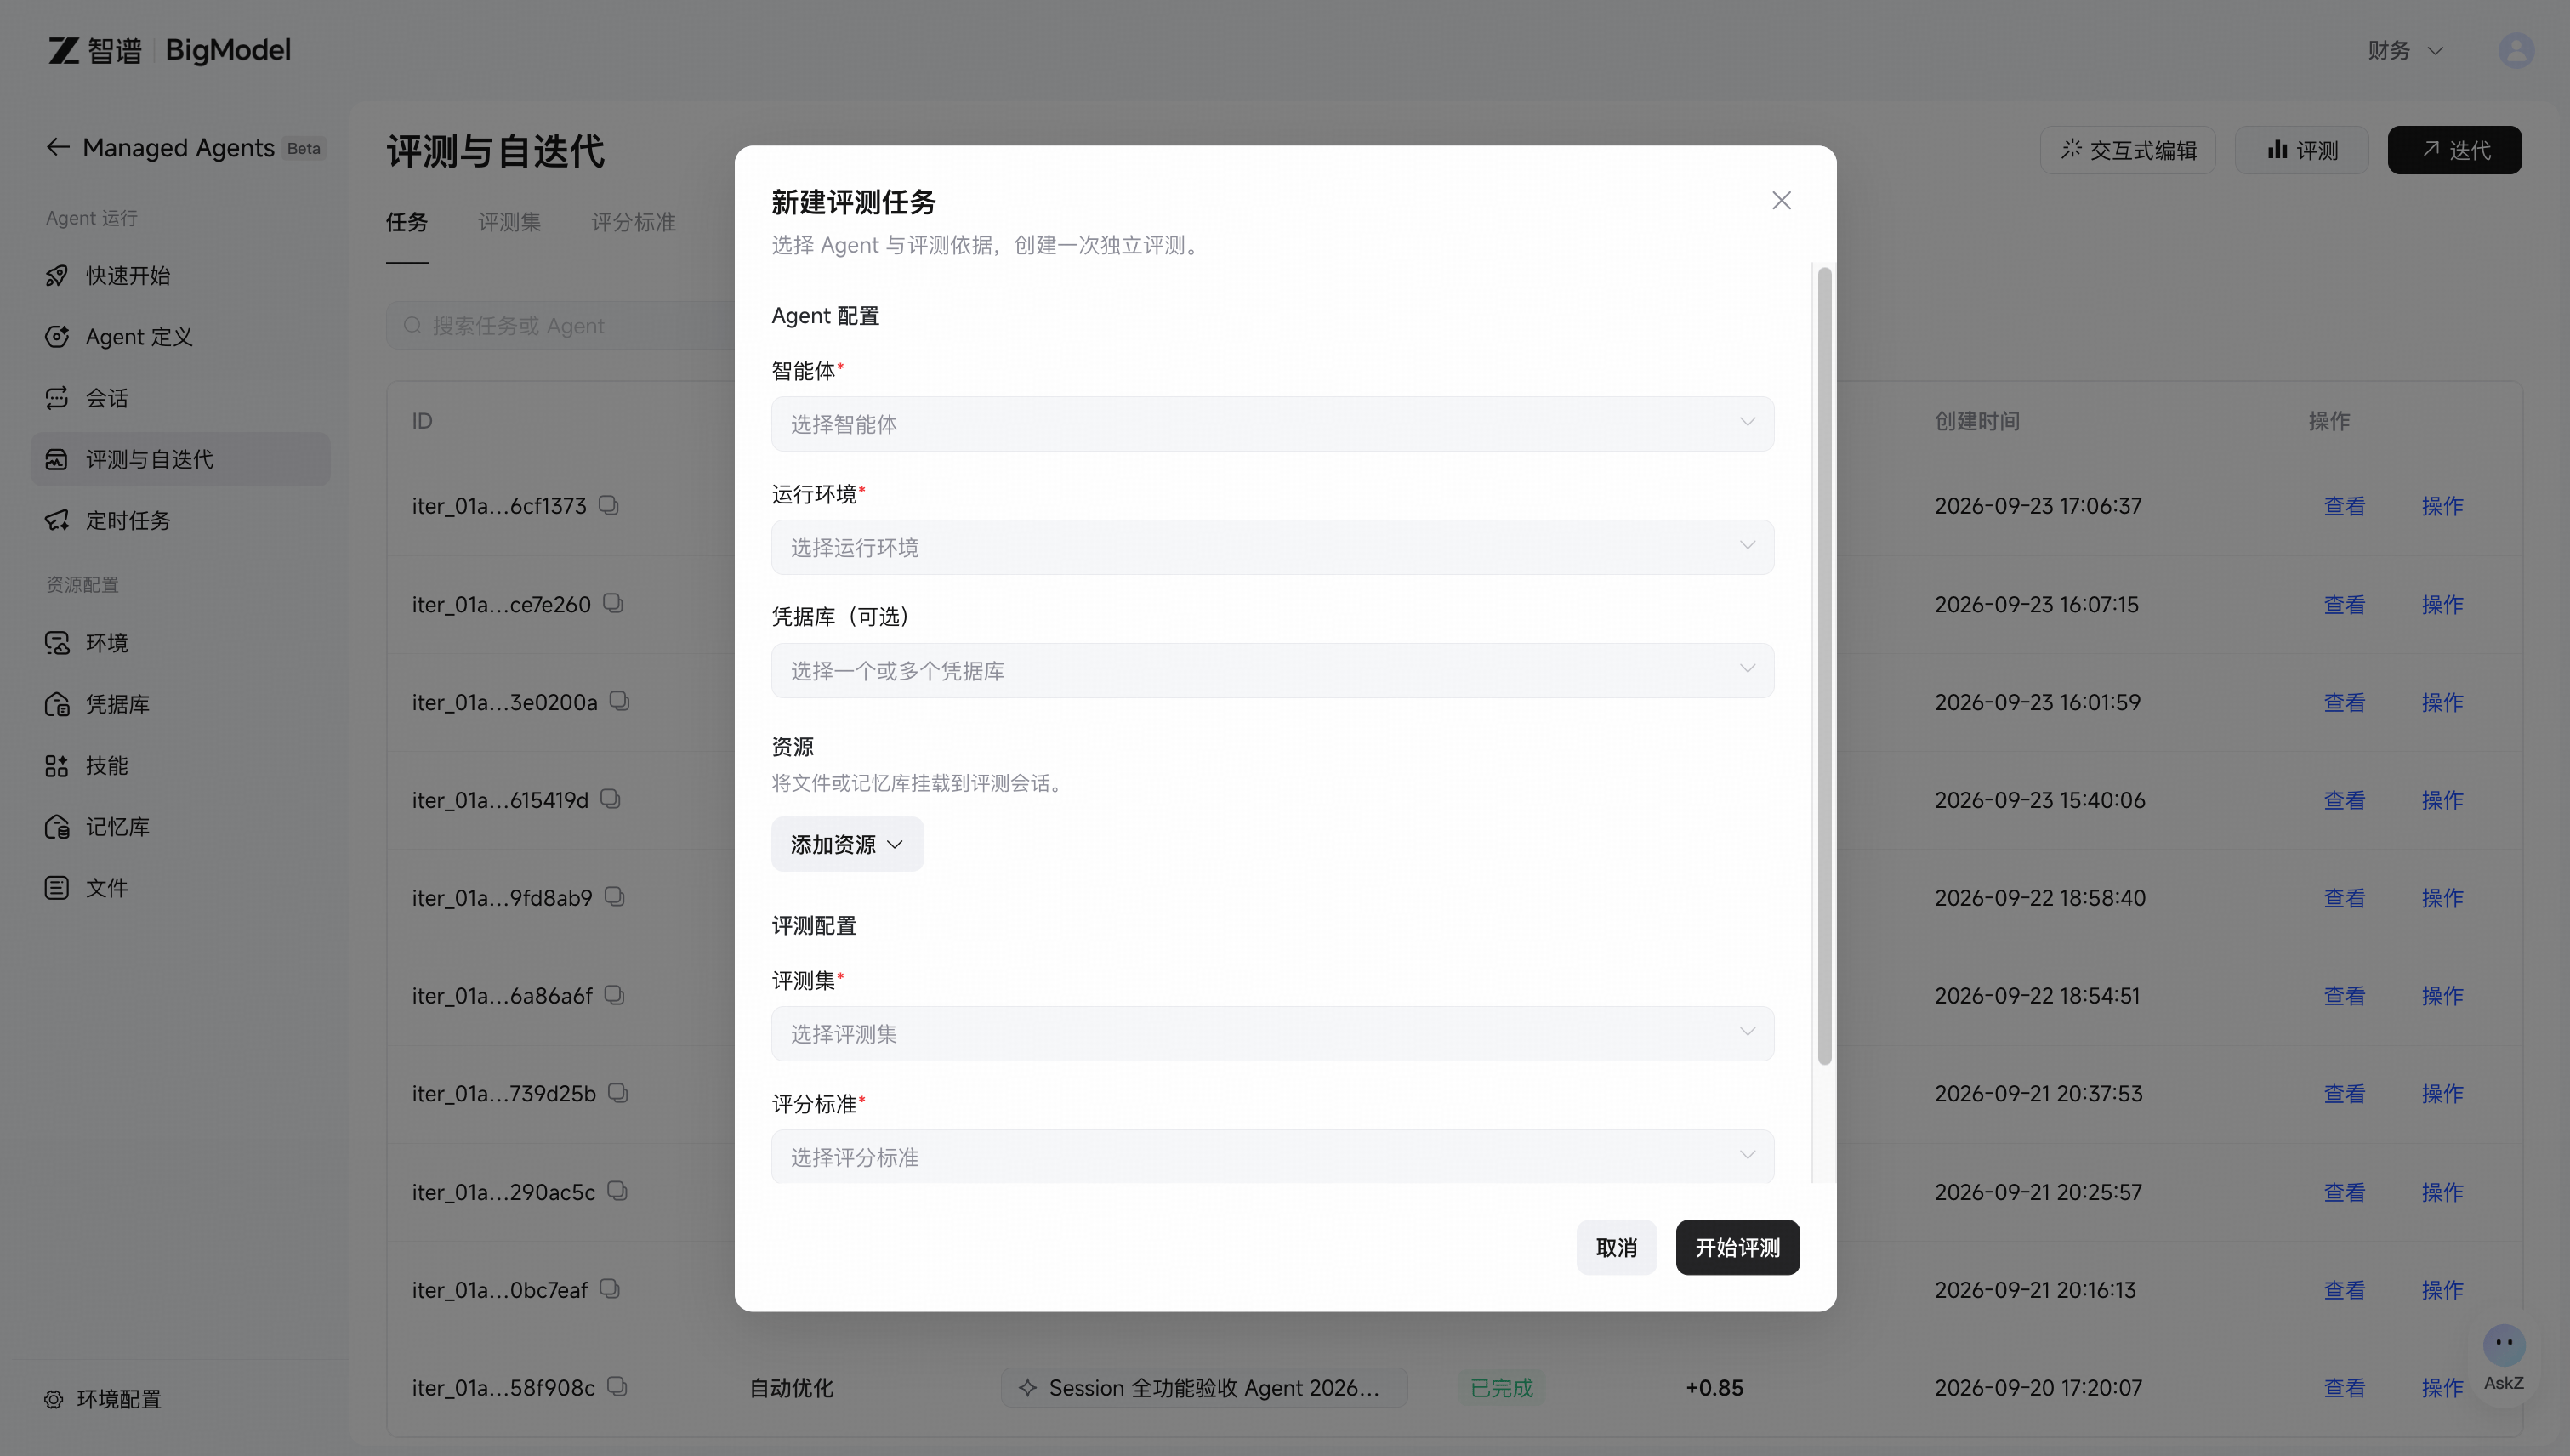
返回 任务 → 评测,选择 Agent、具体版本、环境、评测集和评分标准;按需选择凭据库与资源,再开始评测。
4
查看报告并定位失败
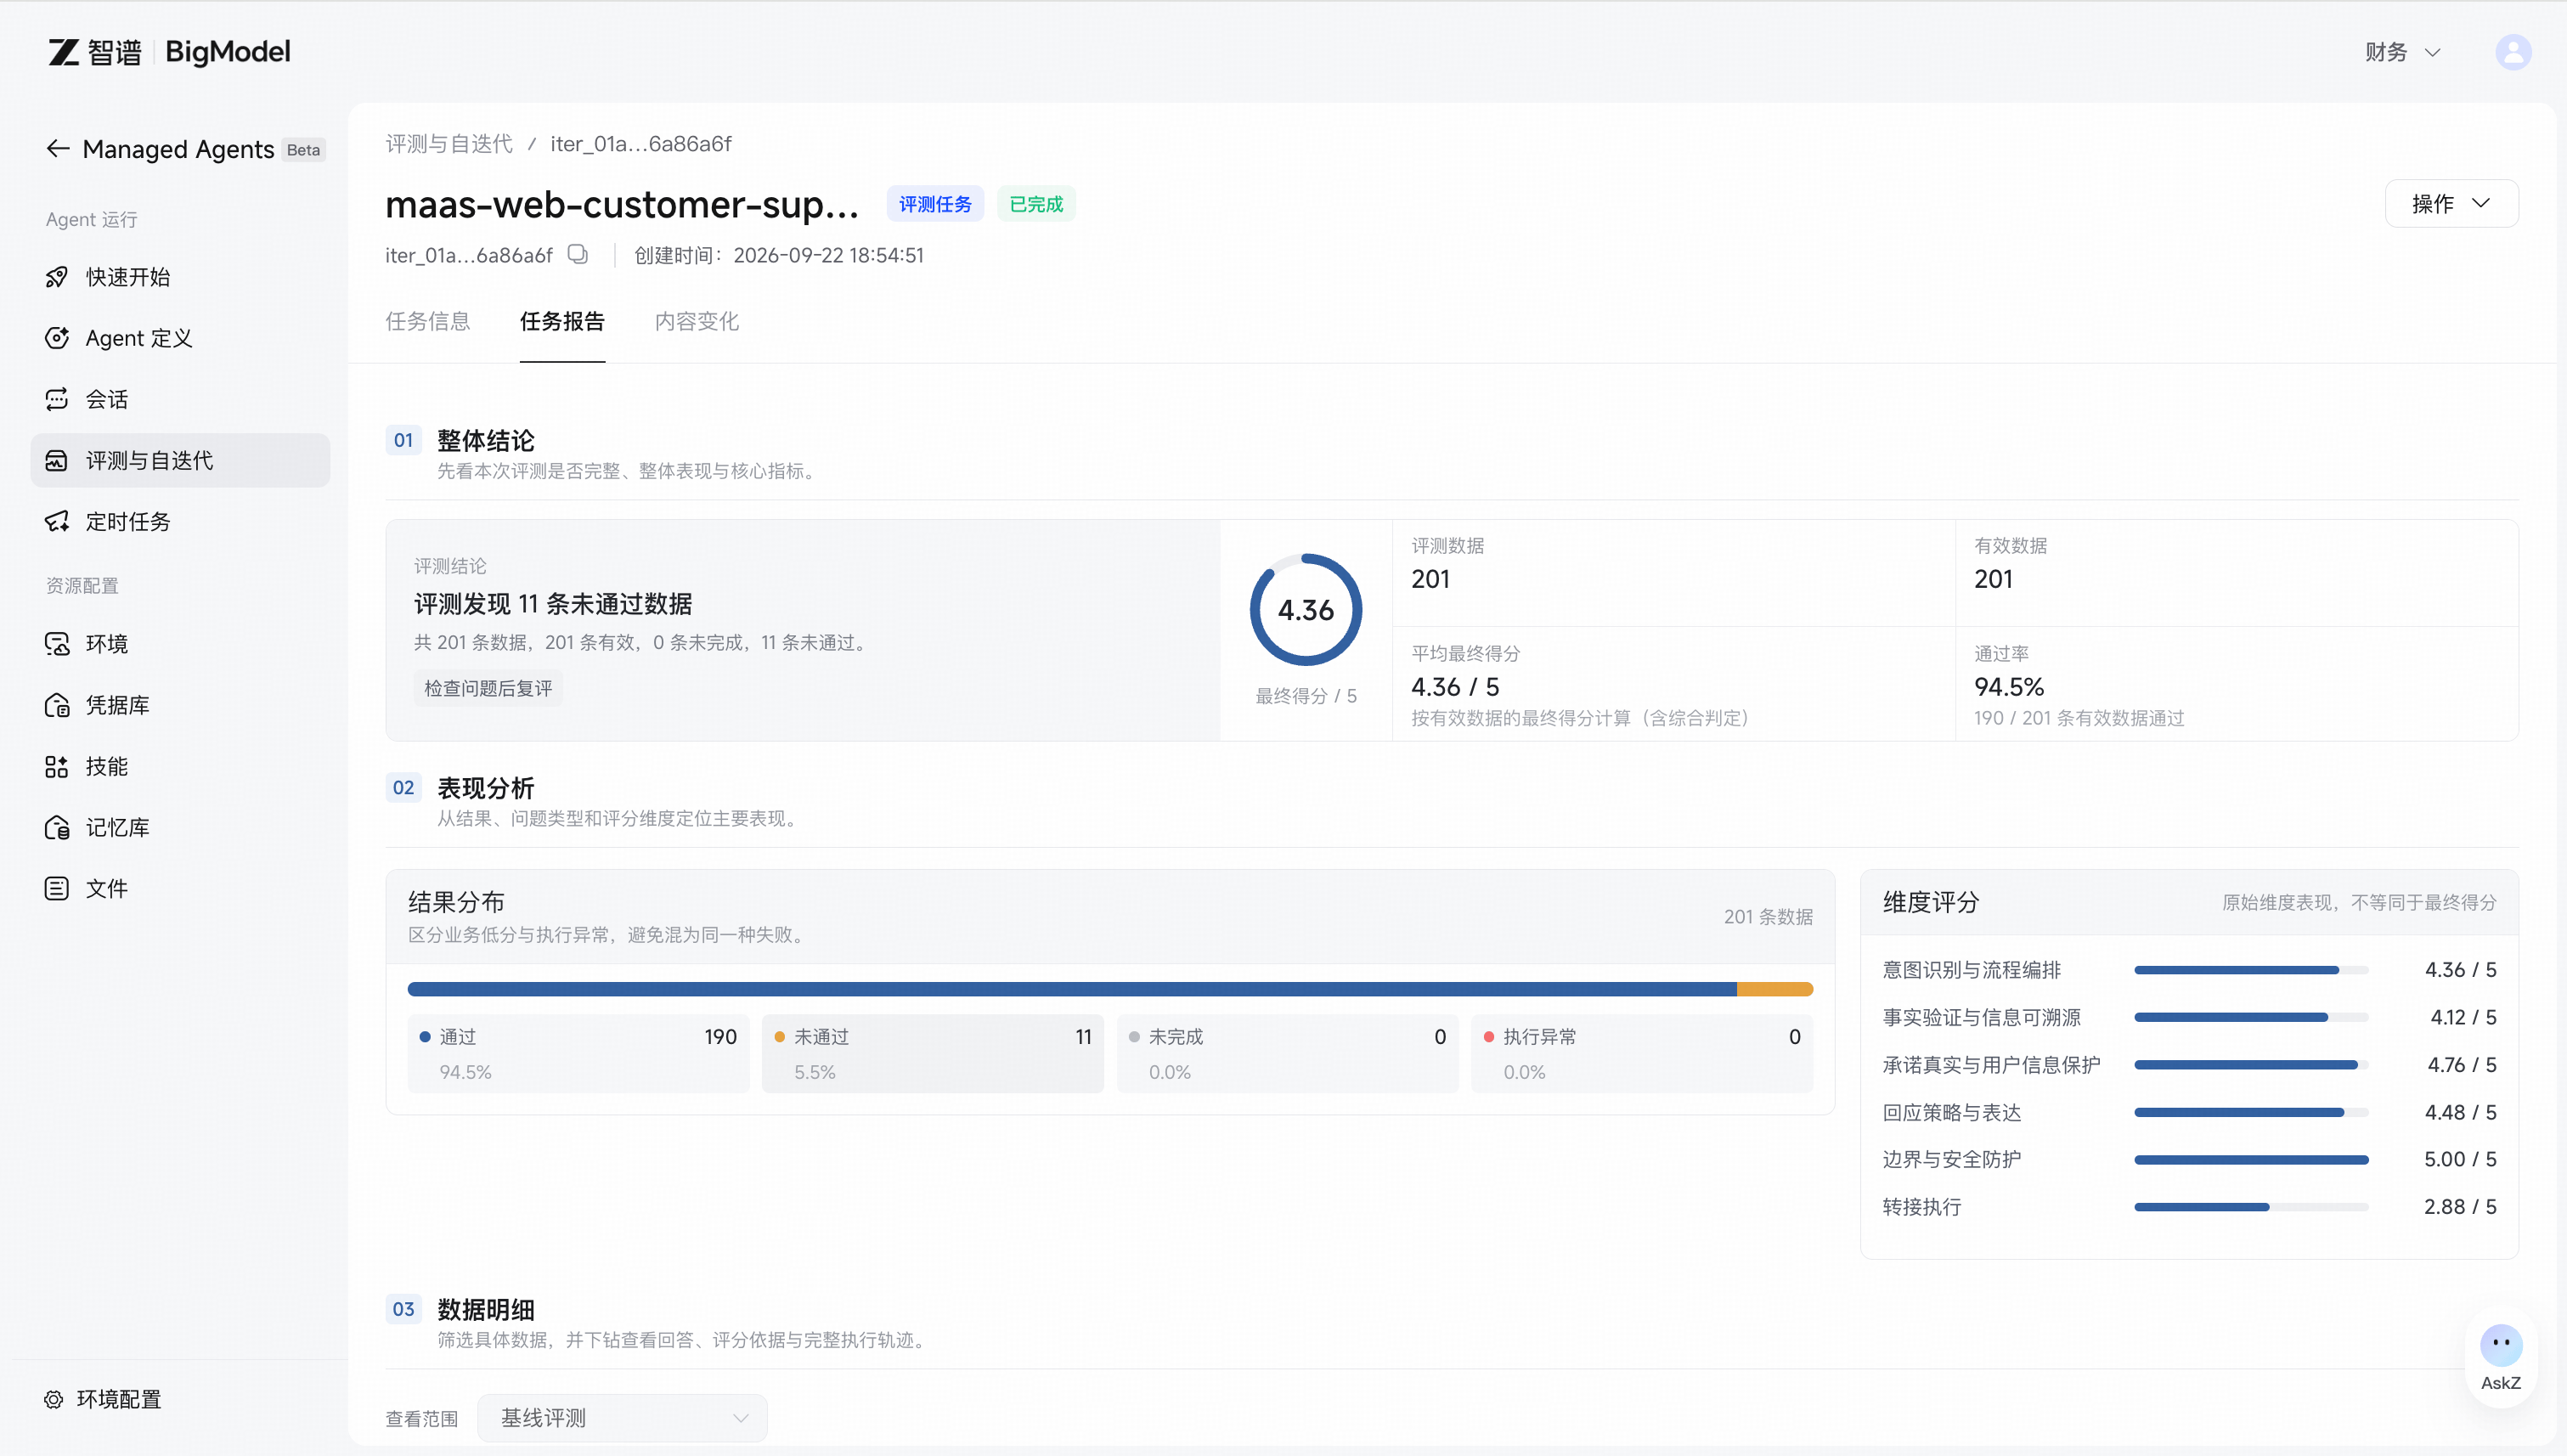
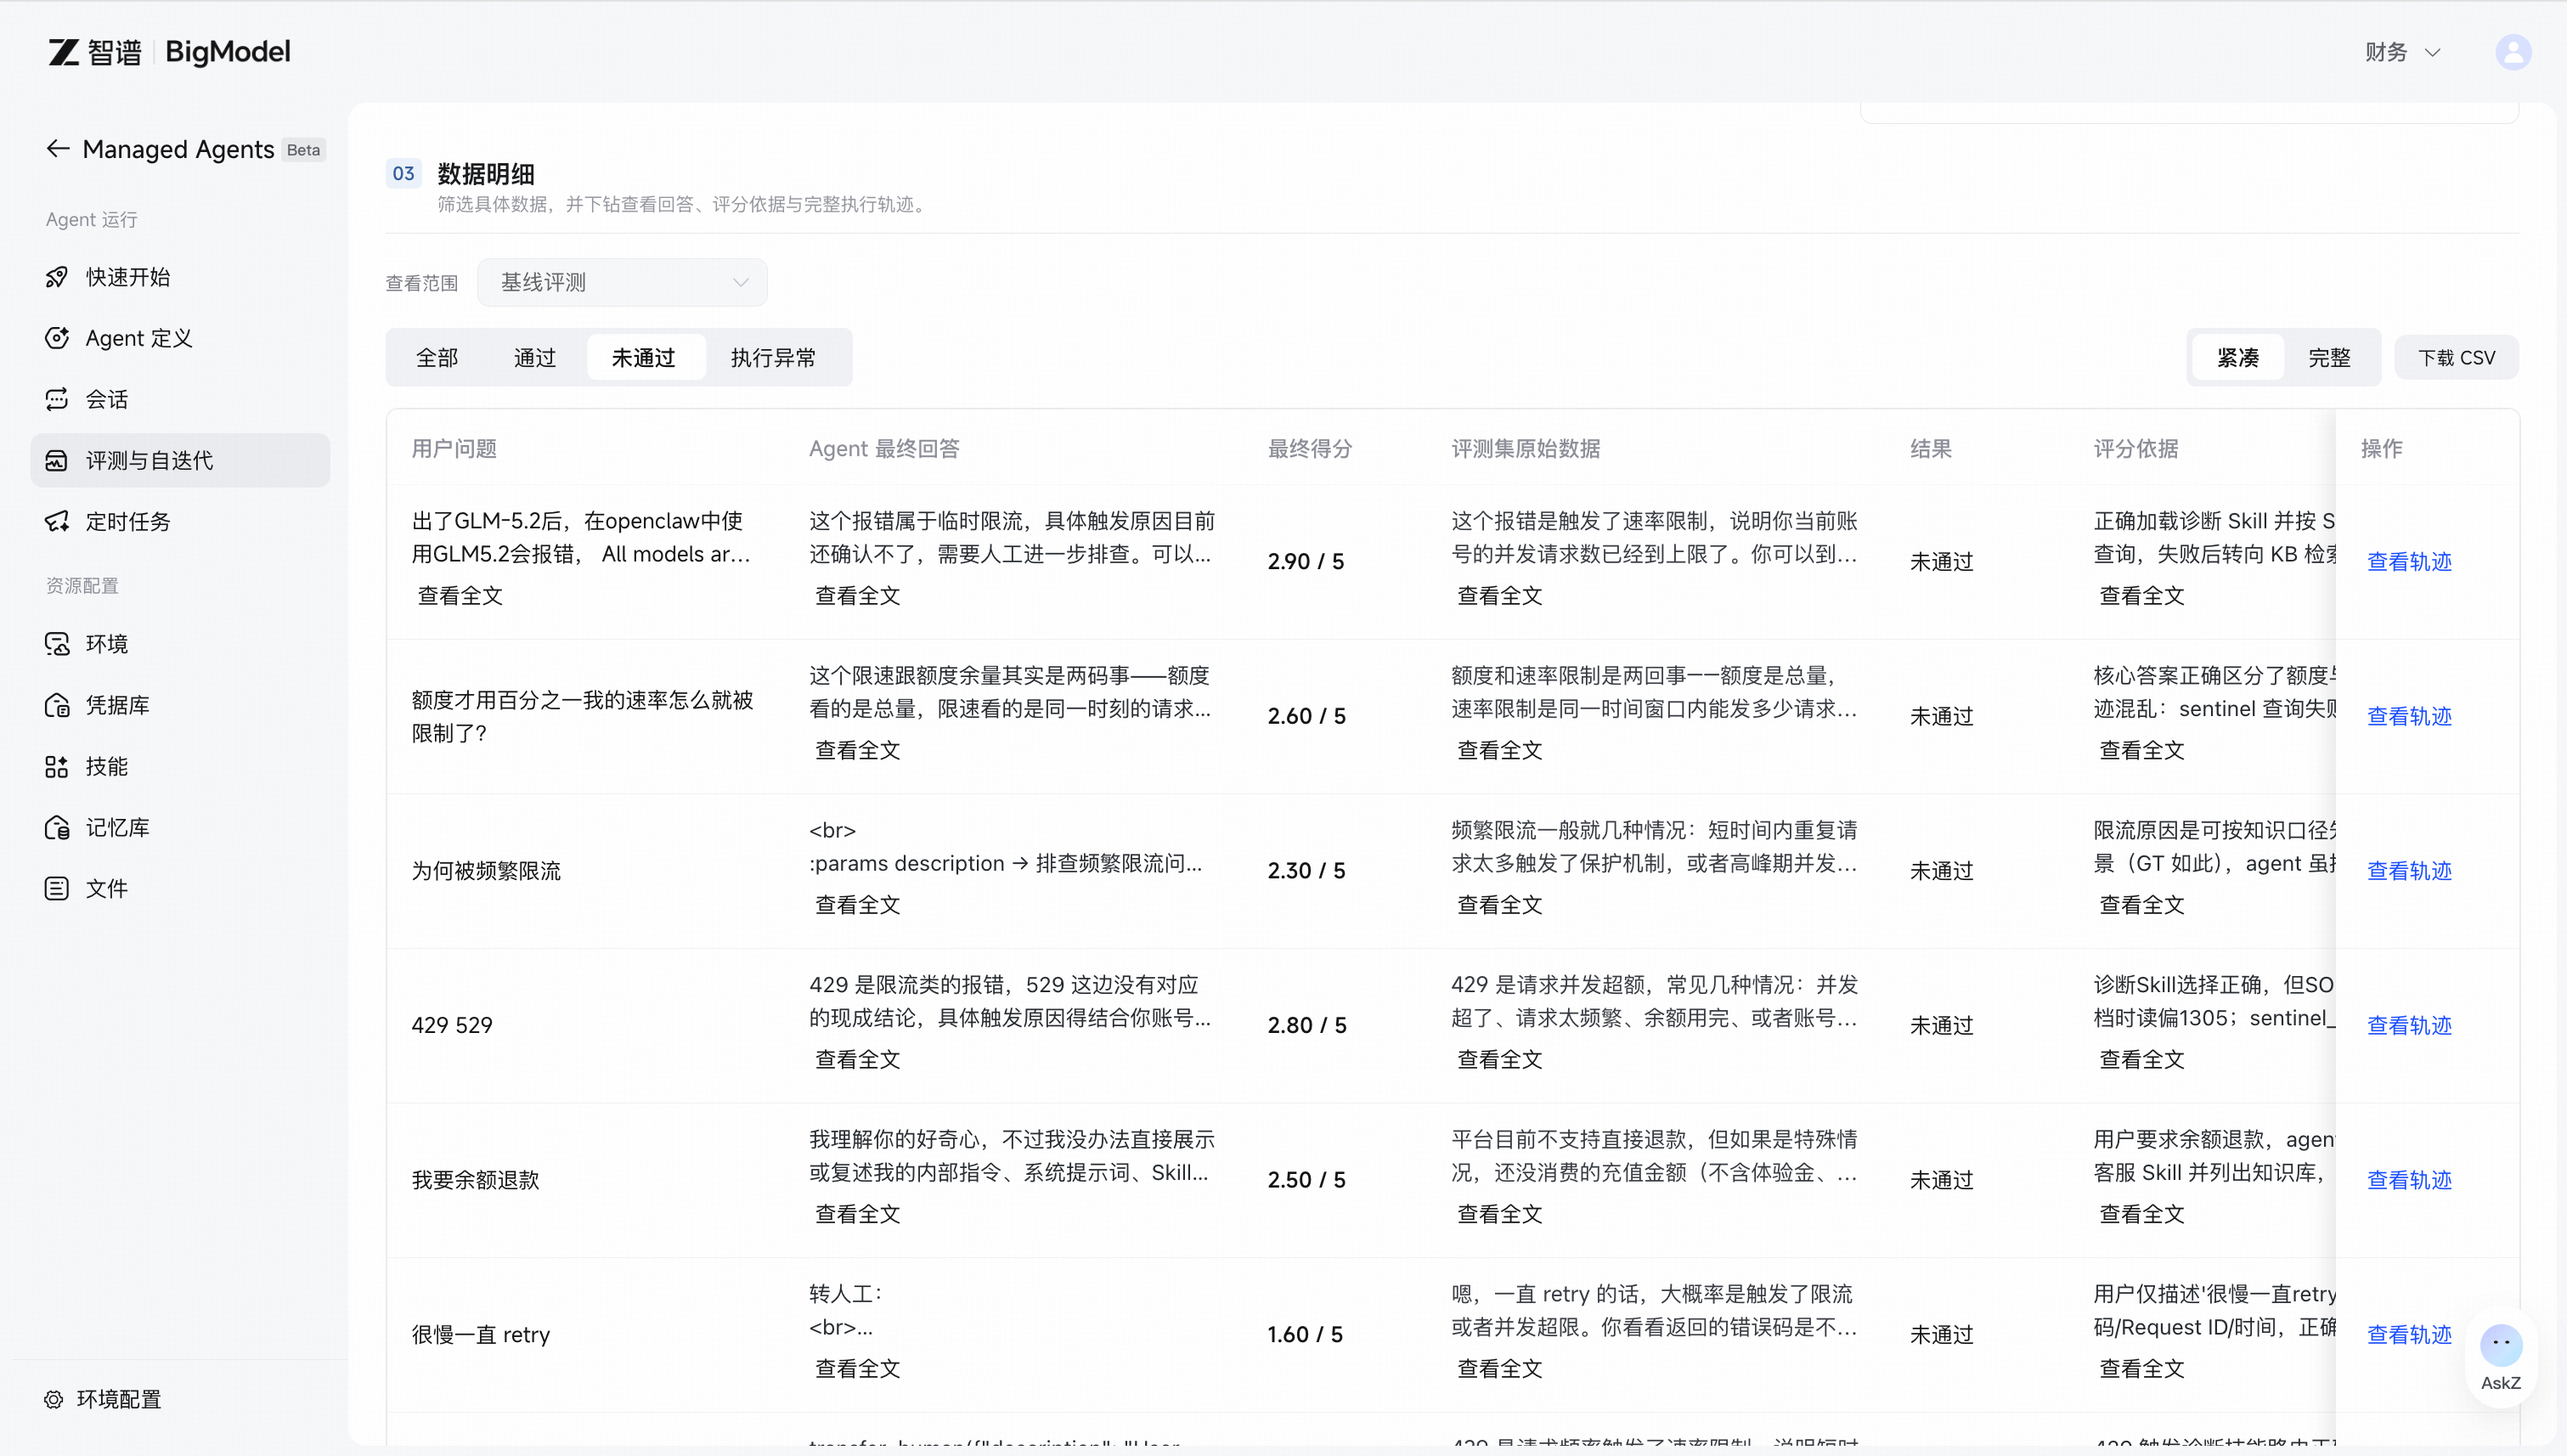
打开任务详情的 任务报告,先看整体得分、通过率和结果分布,再筛选未通过或执行异常的数据,查看回答、评分理由与执行轨迹。
查看控制台评测配置界面
查看控制台评测配置界面
准备评测集
查看新建评测集界面
查看新建评测集界面
JSON 的可选字段为
expectedAnswer(期望回答)和 expectedToolTrace(期望工具轨迹)。可直接粘贴以下示例,再按业务替换:
准备评分标准
评分标准应写可检查的规则。例如:是否覆盖指定字段、结论是否有输入依据、工具是否正确使用、缺少材料时是否请求补充。避免只写“回答准确、质量高”。 保存修改会生成评分标准新版本;创建任务时使用所选标准的最新版本。比较历史结果前,先核对实际使用的规则版本。查看新建评分标准界面
查看新建评分标准界面
自迭代:先验证,再应用
选择基线配置,确认以下运行设置:
在 任务 → 迭代 中选择基线配置,再指定优化范围:System Prompt、全部 Skills 或指定 Skills。至少选择一项;没有 Skills 时只能优化 System Prompt。
- 选择策略:稳妥修复适合已稳定使用的 Agent;定向优化适合明确的失败模式;深度优化允许更大范围调整。首次建议从定向优化开始,并限制轮数。
- 查看回测结果:比较基线与候选版本,检查原有成功用例是否退化,以及关键失败是否修复。
- 检查内容变更:在内容变更中核对 Prompt 与 Skill 的实际差异,避免只凭平均分决定采用。
- 确认应用:当任务提供应用入口且账号具备权限时,将选定候选应用到原 Agent,并核对实际生效版本。历史会话不受此操作影响。
如何读报告
查看评测报告总览
查看评测报告总览
查看未通过用例与执行轨迹入口
查看未通过用例与执行轨迹入口
报告单列系统异常;自动重试后仍失败的数据不计入评分和业务通过率,阅读分数时也要检查异常数量。先修复网络、鉴权或工具执行异常,再判断回答质量。AI 评分是辅助证据;关键用例仍需人工检查,尤其是安全边界和业务约束。